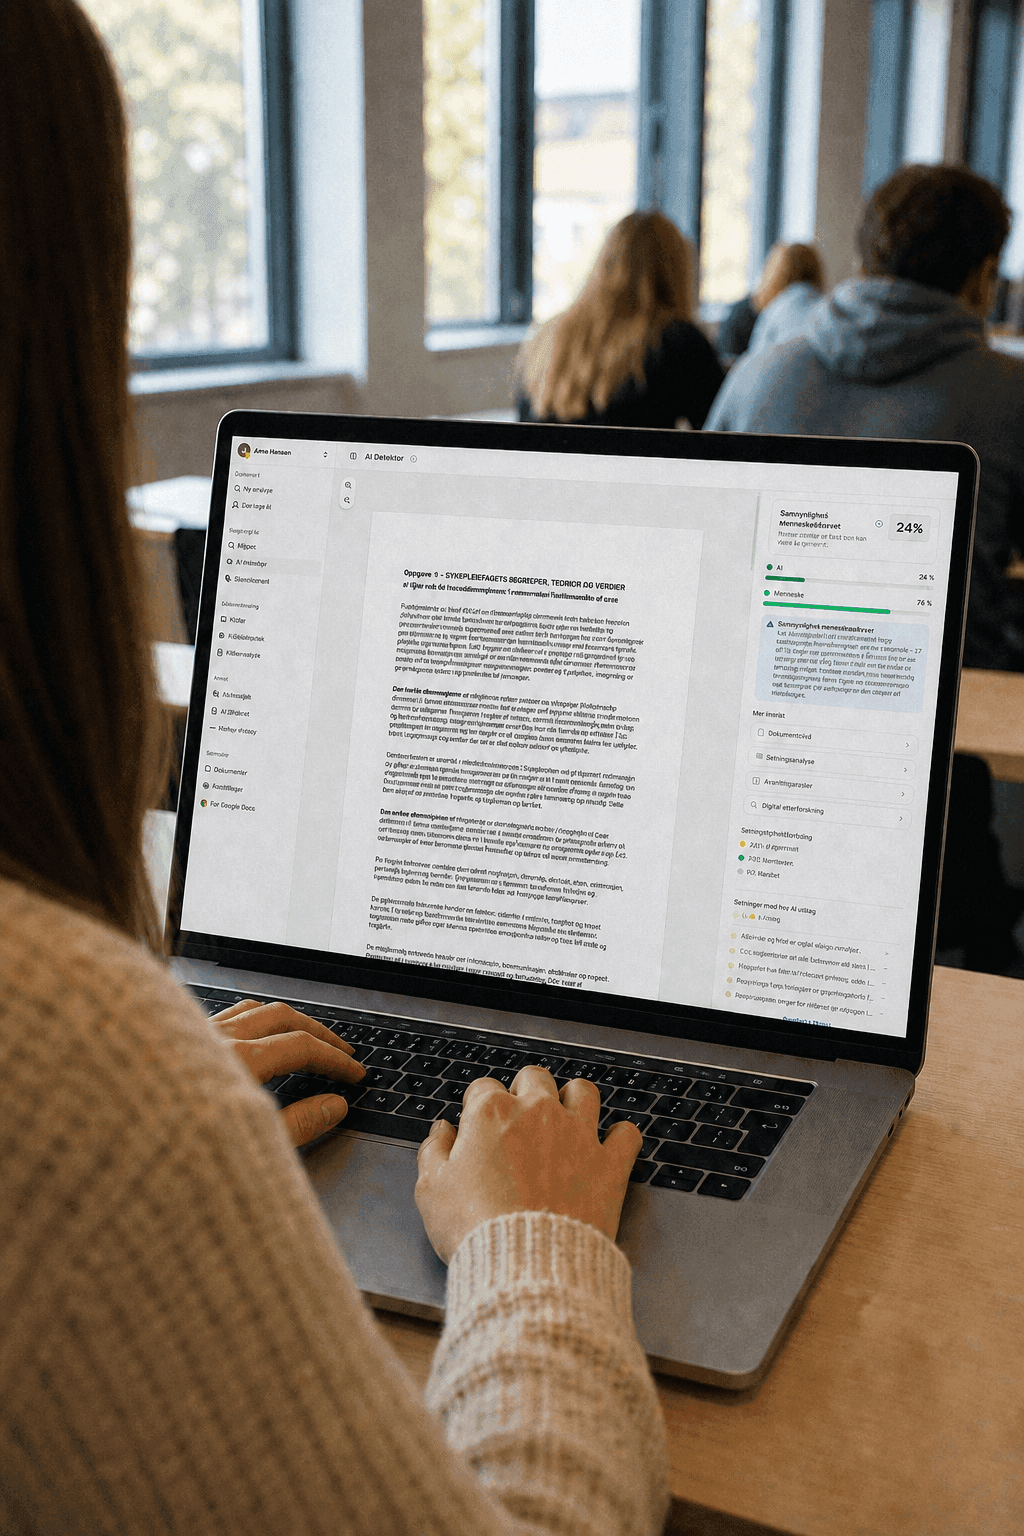
Varje vecka använder studenter, skribenter och forskare Plagiatkontroll för att verifiera textursprung och skilja mänskligt skrivande från maskingenererat innehåll. Tjänsten fungerar som ett centralt verktyg inför inlämningar och hemtentor, vid uppsatshandledning och för att säkra akademisk integritet.
I verkligheten handlar utmaningen sällan om texter som är till 100 % genererade av en språkmodell. Den verkliga svårigheten uppstår i hybridtexter: flera sidor skrivna självständigt av studenten, där enstaka stycken eller meningar har genererats eller formulerats om med AI. Ett annat vanligt problem är att formell, akademisk svenska felaktigt flaggas av internationella detektorer som saknar ett gediget nordiskt träningsunderlag.
Alla svenska analyser drivs nu av NorBERT v3. Modellen bygger vidare på vår etablerade arkitektur, men är tränad på ett mångdubblat och mer balanserat datamaterial. Den identifierar isolerade maskingenererade partier i i övrigt mänskligt skrivna dokument – och håller tveksamma gränsfall utanför den slutliga procentsatsen för att minimera falska positiva.